Homelab-Inventur enthüllt Routing-Logik für KI-Agenten auf begrenzter Hardware
Ein detailliertes Inventar eines vierknotigen Homelabs zeigt, wie 41 Container und eine einzelne 6-GB-GPU das Routing von KI-Agenten zwischen lokaler Ausführung und Cloud-APIs bestimmen.
Automatisch aus dem englischen Original übersetzt.
Ein Entwickler hat am 24. September eine umfassende Bestandsaufnahme seiner selbst gehosteten Infrastruktur veröffentlicht. Darin wird detailliert beschrieben, wie 41 Docker-Container und neun LXC-Container auf vier verschiedenen Hardware-Knoten laufen. Der Bericht hebt die spezifischen Einschränkungen hervor, die durch eine einzelne Grafikkarte mit 6 GB VRAM entstehen. Diese bestimmt letztlich, ob künstliche Intelligenz-Agenten lokal ausgeführt oder an kostenpflichtige Cloud-Dienste weitergeleitet werden.
Was passiert ist
Der Autor führte ein vollständiges Audit seiner Heimlabor-Umgebung durch, um genau zu verstehen, wo Workloads ausgeführt wurden und warum. Das Setup besteht aus zwei Proxmox-Knoten, einem ZimaBlade und einer dedizierten Box für große Sprachmodelle (LLM). Zusammen bieten diese Maschinen 26 CPU-Threads und 71 GB RAM und hosten eine Mischung aus containerisierten Diensten und nativen Anwendungen. Die Bestandsaufnahme ergab, dass die LLM-Box, ausgestattet mit einer RTX 2060, Ollama und ComfyUI direkt ohne Container betreibt, während die anderen Knoten alles von der Hausautomatisierung bis zum Agent-Tracing abdecken.
Ein erheblicher Teil der Analyse konzentrierte sich auf die Grenzen der lokalen KI-Inferenz. Der Autor stellte fest, dass ein Modell mit 27 Milliarden Parametern behauptete, auf der GPU zu laufen, aber tatsächlich nur 0,5 GB seines Footprints von 18,3 GB auf der Grafikkarte platzierte, sodass der Rest langsam auf der CPU verarbeitet wurde. Diese Entdeckung veranlasste eine tiefere Betrachtung, wie die Anforderung des Agent-Frameworks nach einem 64K-Kontextfenster mit dem verfügbaren Videospeicher von 6 GB kollidiert. Infolgedessen wurden die meisten Allzweck-Agenten zu Cloud-Anbietern verschoben, während sensible Aufgaben wie Sicherheitsaudits lokal blieben.
Der Bericht deckte auch betriebliche Ausfälle auf, die durch stille Fehler und Konfigurationsübersehen verursacht wurden. Zum Beispiel verursachte eine doppelte Agent-Instanz mit derselben Netzwerkidentität tagelange Verbindungsprobleme, und ein Health-Check-Probe schlug 17 Tage lang fehl, weil er einen Datenschutzfilter auslöste, anstatt auf einen echten Serviceausfall hinzuweisen. Diese Vorfälle unterstrichen die Notwendigkeit besserer Überwachung und präziserer Fallback-Logik in verteilten selbst gehosteten Umgebungen.
Wichtige Details
- Die Infrastruktur umfasst 41 Docker-Container und 9 LXC-Container, verteilt auf vier physische Boxen.
- Die LLM-Box nutzt eine RTX 2060 mit 6 GB VRAM, was die Auswahl lokaler Modelle auf solche beschränkt, die in strenge Speicherbeschränkungen passen.
- Allgemeine Agenten leiten Anfragen an OpenRouter- oder OpenCode-Go-Abonnements weiter, aufgrund von Latenz- und Kontextfenster-Anforderungen; die kombinierten Kosten liegen bei etwa 11,39 USD pro Monat.
- Sicherheits- und Code-Review-Agenten laufen ausschließlich auf lokalen Ollama-Instanzen, um Datenabfluss zu verhindern.
- Ein Watchdog-System überwacht die Gesundheit der Cloud-API, konnte Dienste jedoch zuvor nicht wiederherstellen, nachdem ein False Positive durch einen Prompt-Redaktionsfilter ausgelöst wurde.
- Stille Hänger in Ollama, bei denen Modelle im Speicher gepinnt blieben, ohne Fehlerprotokolle zu erzeugen, erforderten ein benutzerdefiniertes Skript, das alle 15 Minuten veraltete Prozesse entlädt.
Hintergrund
Das Selbsthosting von KI-Agenten erfordert einen Ausgleich zwischen Rechenressourcen und Leistungsbedarf. Kontextfenster definieren, wie viel Text ein Modell gleichzeitig berücksichtigen kann; größere Fenster erfordern deutlich mehr Speicher. Wenn ein Modell den verfügbaren Videospeicher (VRAM) überschreitet, lagert es in den Systemspeicher aus und nutzt die CPU für Berechnungen, was die Token-Generierung drastisch verlangsamt. In diesem Fall lehnte das Agent-Framework jedes Modell mit weniger als einem 64K-Kontextfenster ab, wodurch viele kleinere, schnellere Modelle eliminiert wurden, die vollständig auf der GPU hätten Platz finden können.
Die Überwachung verteilter Systeme stützt sich oft auf Heartbeat-Checks, bei denen ein Dienst seinen Status in regelmäßigen Intervallen meldet. Schlägt ein Check fehl, lösen automatisierte Systeme typischerweise Warnungen oder Failover-Prozeduren aus. Allerdings können diese Mechanismen durch nicht-standardmäßige Fehler getäuscht werden, wie z. B. wenn eine Sonde von einem Inhaltsfilter abgewiesen wird, statt dass der Server down ist. Den Unterschied zwischen einem harten Fehler und einer logischen Ablehnung zu verstehen, ist entscheidend für die Aufrechterhaltung einer zuverlässigen Verfügbarkeit in komplexen Homelabs.
Warum es wichtig ist
Für Teams, die ihre eigene Software betreiben, illustriert diese Bestandsaufnahme die versteckte Komplexität beim Management hybrider KI-Workflows. Sie zeigt, dass Hardware-Spezifikationen allein die Leistung nicht bestimmen; Software-Einschränkungen wie Kontextfenster-Anforderungen können teure Cloud-Nutzung erzwingen, selbst wenn die lokale Hardware scheinbar ausreichend erscheint. Ingenieure müssen tatsächlichen Token-Verbrauch und Latenz messen, anstatt sich auf Headline-Spezifikationen zu verlassen, da input-lastige Workloads günstige Cloud-Modelle wirtschaftlicher machen können als die Wartung großer lokaler Server.
Der Vorfall mit dem 17-tägigen Ausfall hebt die Fragilität automatisierter Wiederherstellungssysteme hervor. Wenn die Überwachungslogik nicht alle Fehlermodi berücksichtigt, wie z. B. Upstream-Filter, die Sonden blockieren, bleiben Teams möglicherweise lange Zeit unwissentlich über degradierte Leistungen informiert. Dies verstärkt die Notwendigkeit robuster Observability-Tools, die zwischen Service-Unverfügbarkeit und logischen Fehlern unterscheiden können, um sicherzustellen, dass Fallbacks korrekt aktivieren und den normalen Betrieb ohne manuelle Eingriffe wiederherstellen.
Was Sie tun können
- Auditiert Ihr Inventar an Containern und virtuellen Maschinen, um doppelte Dienste oder ungenutzte Ressourcen zu identifizieren, die Speicher verbrauchen.
- Messen Sie das tatsächliche Verhältnis von Token-Eingabe zu Ausgabe, um zu bestimmen, ob Cloud-API-Kosten durch Volumen oder Modellwahl getrieben werden.
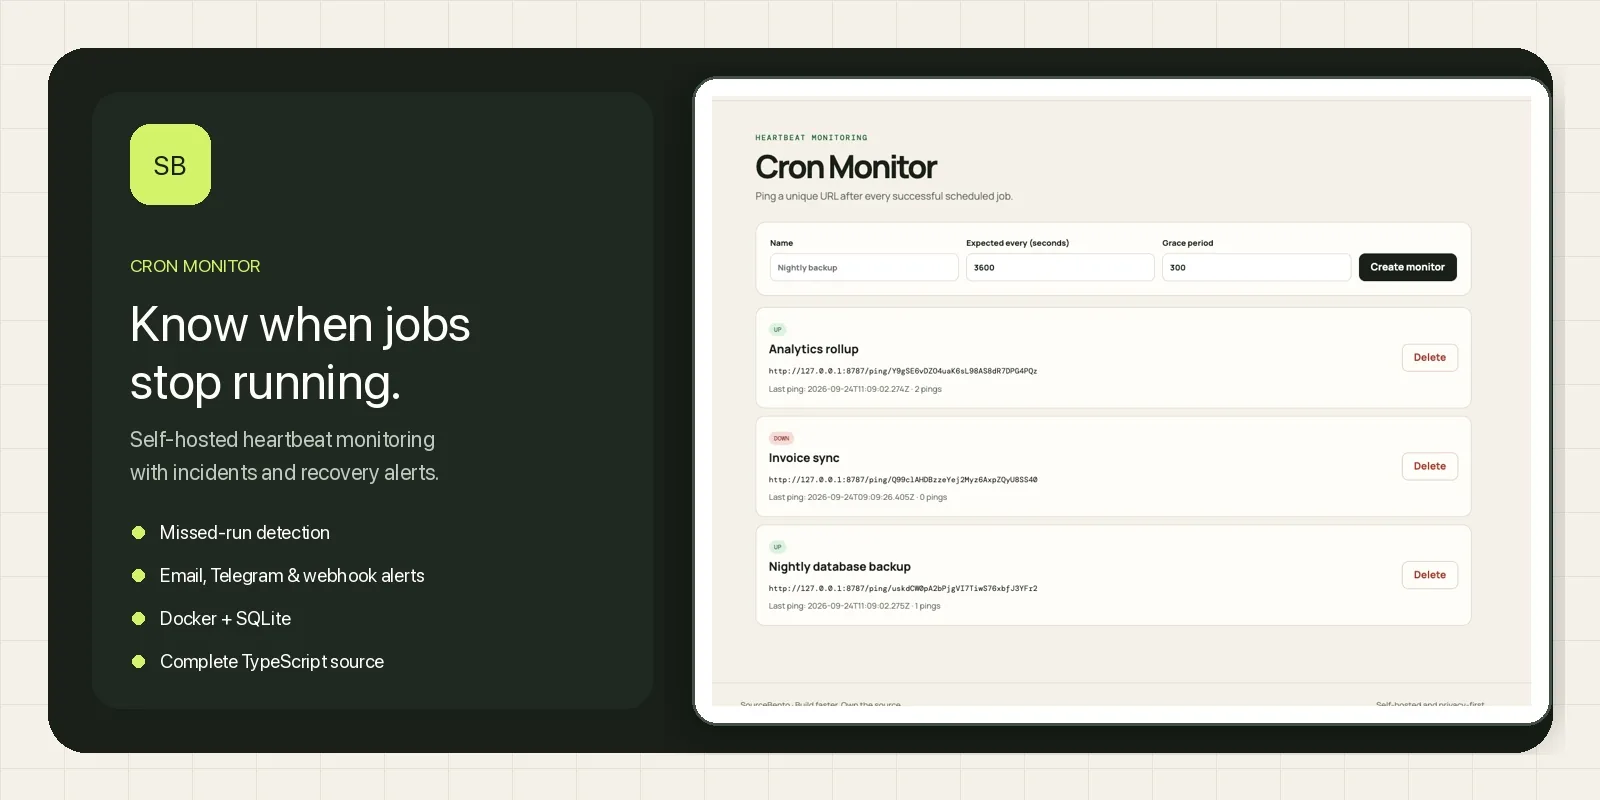
- Implementieren Sie Heartbeat-Monitoring für alle kritischen Hintergrund-Jobs und KI-Dienste, um stille Hänger oder Stillstände zu erkennen.
- Konfigurieren Sie Fallback-Ketten mit verschiedenen Anbietern, um Single Points of Failure zu vermeiden, wenn ein Anbieter Probleme hat.
- Testen Sie regelmäßig Health-Check-Sonden, um sicherzustellen, dass sie nicht durch Datenschutzfilter oder Inhaltsrichtlinien blockiert werden.
- Erstellen Sie Skripte, die idle Modelle automatisch aus dem GPU-Speicher entladen, falls Ihre Inferenz-Engine Ressourcenkonflikte nicht sauber handhabt.