Un recensement de homelab révèle la logique de routage des agents IA sur un matériel limité
Un inventaire détaillé d'un homelab à quatre nœuds montre comment 41 conteneurs et un seul GPU de 6 Go dictent le routage des agents IA entre l'exécution locale et les API cloud.
Traduit automatiquement depuis l’original en anglais.
Un développeur a publié le 24 septembre un recensement complet de son infrastructure auto-hébergée, détaillant comment 41 conteneurs Docker et neuf conteneurs LXC fonctionnent sur quatre nœuds matériels distincts. Le rapport met en évidence les contraintes spécifiques imposées par une seule carte graphique de 6 Go, qui détermine finalement si les agents d'intelligence artificielle s'exécutent localement ou sont routés vers des services cloud payants.
Ce qui s'est passé
L'auteur a réalisé un audit complet de son environnement de laboratoire domestique pour comprendre exactement où les charges de travail étaient exécutées et pourquoi. La configuration se compose de deux nœuds Proxmox, d'un ZimaBlade et d'une machine dédiée aux grands modèles de langage (LLM). Ensemble, ces machines offrent 26 threads CPU et 71 Go de RAM, hébergeant un mélange de services conteneurisés et d'applications natives. Le recensement a révélé que la machine LLM, équipée d'une RTX 2060, exécute Ollama et ComfyUI directement sans conteneurs, tandis que les autres nœuds gèrent tout, de l'automatisation domestique au traçage des agents.
Une part importante de l'analyse s'est concentrée sur les limites de l'inférence IA locale. L'auteur a constaté qu'un modèle de 27 milliards de paramètres prétendait fonctionner sur le GPU, mais ne plaçait en réalité que 0,5 Go de son empreinte de 18,3 Go sur la carte graphique, laissant le reste être traité lentement par le CPU. Cette découverte a incité à examiner plus en profondeur comment l'exigence du framework d'agents pour une fenêtre de contexte de 64K entre en conflit avec les 6 Go de mémoire vidéo disponibles. Par conséquent, la plupart des agents à usage général ont été déplacés vers des fournisseurs cloud, tandis que les tâches sensibles comme les audits de sécurité sont restées locales.
Le rapport a également révélé des défaillances opérationnelles causées par des erreurs silencieuses et des négligences de configuration. Par exemple, une instance d'agent dupliquée avec la même identité réseau a provoqué plusieurs jours de problèmes de connectivité, et une sonde de vérification de santé a échoué pendant 17 jours parce qu'elle déclenchait un filtre de confidentialité plutôt que d'indiquer une véritable panne de service. Ces incidents ont souligné la nécessité d'une meilleure surveillance et d'une logique de repli plus précise dans les environnements auto-hébergés distribués.
Détails clés
- L'infrastructure comprend 41 conteneurs Docker et 9 conteneurs LXC répartis sur quatre boîtiers physiques.
- La machine LLM utilise une RTX 2060 avec 6 Go de VRAM, ce qui limite la sélection de modèles locaux à ceux respectant des contraintes mémoire strictes.
- Les agents généraux sont routés vers des abonnements OpenRouter ou OpenCode Go en raison des exigences de latence et de fenêtre de contexte, coûtant environ 11,39 $ par mois au total.
- Les agents de sécurité et de revue de code fonctionnent exclusivement sur des instances Ollama locales pour empêcher toute fuite de données.
- Un système watchdog surveille la santé des API cloud, mais il a précédemment échoué à restaurer les services après un faux positif causé par un filtre de censure des prompts.
- Des blocages silencieux dans Ollama, où les modèles restaient épinglés en mémoire sans journaux d'erreurs, ont nécessité un script personnalisé pour décharger les processus obsolètes toutes les 15 minutes.
Contexte
L'auto-hébergement d'agents IA implique un équilibre entre les ressources informatiques et les besoins de performance. Les fenêtres de contexte définissent la quantité de texte qu'un modèle peut considérer simultanément, les fenêtres plus larges nécessitant significativement plus de mémoire. Lorsqu'un modèle dépasse la mémoire vidéo disponible (VRAM), il déborde dans la RAM système et utilise le CPU pour les calculs, ralentissant drastiquement la génération de tokens. Dans ce cas, le framework d'agents refusait tout modèle ayant une fenêtre de contexte inférieure à 64K, éliminant de nombreux modèles plus petits et plus rapides qui auraient pu tenir entièrement sur le GPU.
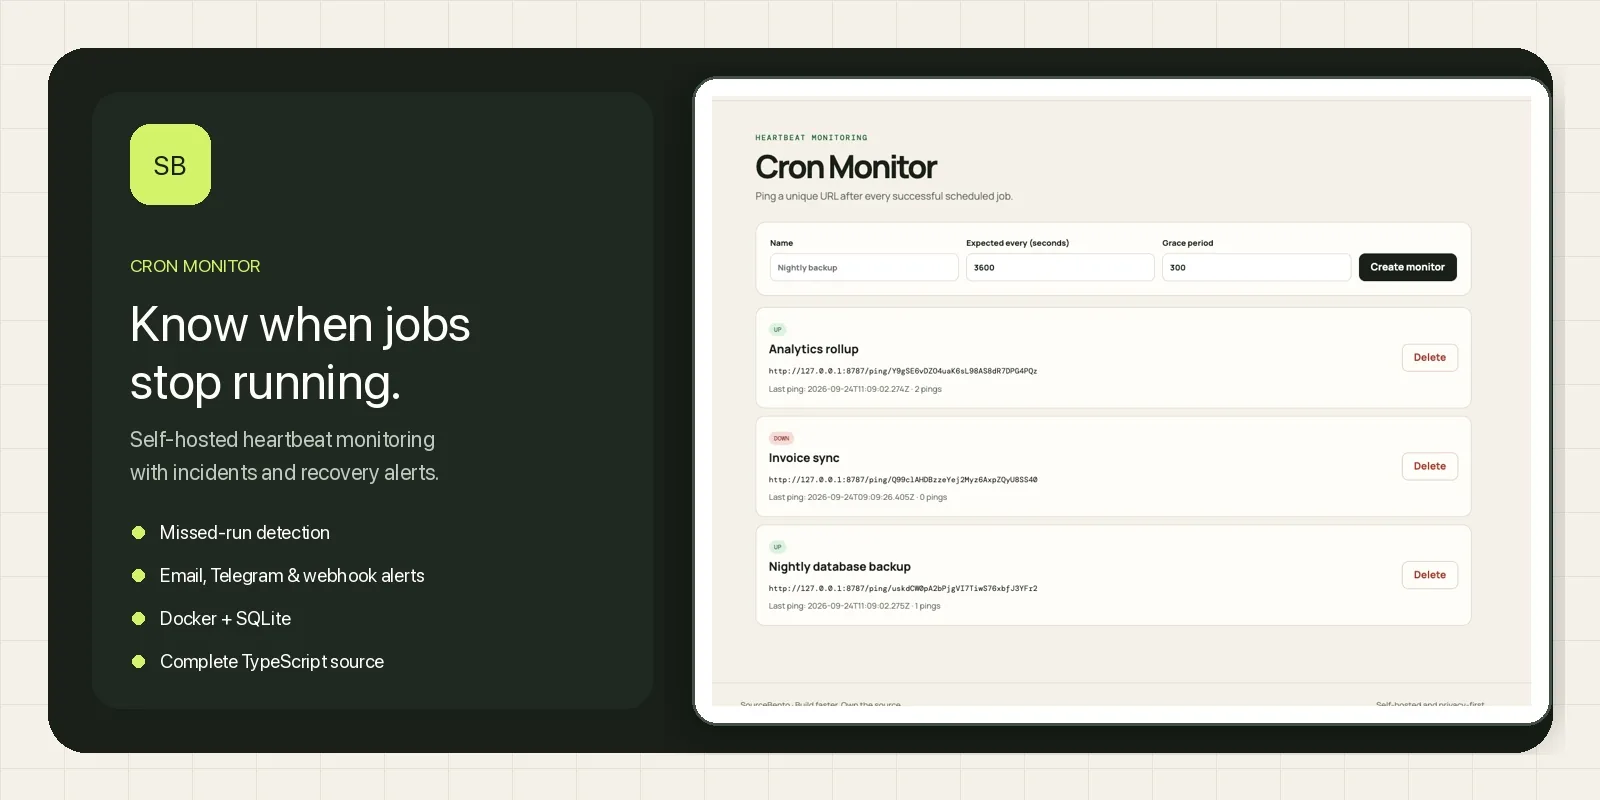
La surveillance des systèmes distribués repose souvent sur des vérifications de battement de cœur (heartbeat checks), où un service signale son statut à intervalles réguliers. Si une vérification échoue, les systèmes automatisés déclenchent généralement des alertes ou des procédures de basculement. Cependant, ces mécanismes peuvent être trompés par des défaillances non standard, telles qu'une sonde rejetée par un filtre de contenu plutôt qu'un serveur hors ligne. Comprendre la différence entre une erreur matérielle et un rejet logique est crucial pour maintenir une disponibilité fiable dans des homelabs complexes.
Pourquoi cela compte
Pour les équipes exploitant leurs propres logiciels, ce recensement illustre la complexité cachée de la gestion des workflows IA hybrides. Il démontre que les spécifications matérielles seules ne déterminent pas la performance ; les contraintes logicielles comme les exigences de fenêtre de contexte peuvent forcer l'utilisation coûteuse du cloud même lorsque le matériel local semble suffisant. Les ingénieurs doivent mesurer l'utilisation réelle des tokens et la latence plutôt que de se fier aux spécifications principales, car les charges de travail lourdes en entrées peuvent rendre les modèles cloud bon marché plus économiques que le maintien de grands serveurs locaux.
L'incident de la panne de 17 jours met en lumière la fragilité des systèmes de récupération automatisés. Lorsque la logique de surveillance ne tient pas compte de tous les modes de défaillance, tels que les filtres amont bloquant les sondes, les équipes peuvent rester inconscientes d'une dégradation des performances pendant de longues périodes. Cela renforce le besoin d'outils d'observabilité robustes capables de distinguer l'indisponibilité du service des erreurs logiques, garantissant que les replis s'activent correctement et restaurent les opérations normales sans intervention manuelle.
Ce que vous pouvez faire
- Auditez votre inventaire de conteneurs et de machines virtuelles pour identifier les services dupliqués ou les ressources inutilisées consommant de la mémoire.
- Mesurez les ratios réels d'entrée versus sortie de tokens pour déterminer si les coûts des API cloud sont dus au volume ou au choix du modèle.
- Implémentez une surveillance par battement de cœur pour tous les travaux d'arrière-plan critiques et les services IA afin de détecter les blocages ou arrêts silencieux.
- Configurez des chaînes de repli avec divers fournisseurs pour éviter les points uniques de défaillance lorsqu'un fournisseur rencontre des problèmes.
- Testez régulièrement les sondes de vérification de santé pour vous assurer qu'elles ne sont pas bloquées par des filtres de confidentialité ou des politiques de contenu.
- Créez des scripts pour décharger automatiquement les modèles inactifs de la mémoire GPU si votre moteur d'inférence ne gère pas gracieusement la contention des ressources.