Cuộc tổng điều tra homelab tiết lộ logic định tuyến cho các tác nhân AI trên phần cứng hạn chế
Một bản kiểm kê chi tiết về hệ thống homelab bốn nút cho thấy cách 41 container và một GPU 6 GB quyết định việc định tuyến các tác nhân AI giữa thực thi cục bộ và API đám mây.
Bài được dịch tự động từ bản gốc tiếng Anh.
Một nhà phát triển đã công bố một cuộc tổng điều tra toàn diện về cơ sở hạ tầng tự lưu trữ (self-hosted) của họ vào ngày 24 tháng 9, mô tả chi tiết cách 41 Docker container và chín LXC container hoạt động trên bốn nút phần cứng riêng biệt. Báo cáo nhấn mạnh những ràng buộc cụ thể do một card đồ họa 6 GB duy nhất gây ra, yếu tố cuối cùng quyết định xem các tác nhân trí tuệ nhân tạo chạy cục bộ hay được chuyển hướng đến các dịch vụ đám mây trả phí.
Chuyện gì đã xảy ra
Tác giả đã tiến hành một cuộc kiểm toán đầy đủ môi trường phòng thí nghiệm tại gia (home laboratory) để hiểu chính xác nơi nào các khối lượng công việc đang được thực thi và lý do tại sao. Thiết lập bao gồm hai nút Proxmox, một ZimaBlade và một máy chuyên dụng cho mô hình ngôn ngữ lớn (LLM). Tổng cộng, các máy này cung cấp 26 luồng CPU và 71 GB RAM, lưu trữ sự kết hợp giữa các dịch vụ dạng container và ứng dụng gốc. Cuộc tổng điều tra cho thấy máy LLM, được trang bị RTX 2060, chạy trực tiếp Ollama và ComfyUI mà không dùng container, trong khi các nút khác xử lý mọi thứ từ tự động hóa nhà cửa đến theo dõi tác nhân.
Một phần đáng kể của phân tích tập trung vào những hạn chế của suy luận AI cục bộ. Tác giả phát hiện ra rằng một mô hình 27 tỷ tham số được tuyên bố là chạy trên GPU nhưng thực tế chỉ đặt 0,5 GB trong số 18,3 GB dung lượng của nó lên card đồ họa, phần còn lại phải xử lý chậm chạp trên CPU. Phát hiện này thúc đẩy một cái nhìn sâu sắc hơn về cách yêu cầu cửa sổ ngữ cảnh 64K của khung tác nhân xung đột với bộ nhớ video 6 GB khả dụng. Kết quả là, hầu hết các tác nhân đa năng đã được chuyển sang các nhà cung cấp đám mây, trong khi các nhiệm vụ nhạy cảm như kiểm toán bảo mật vẫn được giữ cục bộ.
Báo cáo cũng phát hiện ra các lỗi vận hành do lỗi im lặng và sơ suất cấu hình. Ví dụ, một phiên bản tác nhân trùng lặp có cùng danh tính mạng đã gây ra nhiều ngày vấn đề kết nối, và một đầu dò kiểm tra sức khỏe đã thất bại trong 17 ngày vì nó kích hoạt bộ lọc quyền riêng tư thay vì chỉ ra sự cố dịch vụ thực sự. Những sự cố này nhấn mạnh nhu cầu về giám sát tốt hơn và logic dự phòng chính xác hơn trong các môi trường tự lưu trữ phân tán.
Chi tiết chính
- Cơ sở hạ tầng bao gồm 41 Docker container và 9 LXC container trải rộng trên bốn hộp vật lý.
- Máy LLM sử dụng RTX 2060 với 6 GB VRAM, điều này giới hạn việc lựa chọn mô hình cục bộ chỉ ở những mô hình phù hợp với các ràng buộc bộ nhớ nghiêm ngặt.
- Các tác nhân chung được định tuyến đến các đăng ký OpenRouter hoặc OpenCode Go do yêu cầu về độ trễ và cửa sổ ngữ cảnh, với chi phí khoảng $11,39 mỗi tháng tổng cộng.
- Các tác nhân bảo mật và đánh giá mã nguồn chạy độc quyền trên các phiên bản Ollama cục bộ để ngăn chặn rò rỉ dữ liệu.
- Một hệ thống watchdog giám sát sức khỏe API đám mây nhưng trước đây đã thất bại trong việc khôi phục dịch vụ sau một báo động giả do bộ lọc che giấu prompt gây ra.
- Các trường hợp treo im lặng trong Ollama, nơi các mô hình vẫn bị ghim trong bộ nhớ mà không có nhật ký lỗi, đòi hỏi một script tùy chỉnh để giải phóng các tiến trình cũ kỹ mỗi 15 phút.
Bối cảnh
Việc tự lưu trữ các tác nhân AI liên quan đến việc cân bằng tài nguyên tính toán với nhu cầu hiệu suất. Cửa sổ ngữ cảnh xác định lượng văn bản mà một mô hình có thể xem xét cùng lúc, với các cửa sổ lớn hơn đòi hỏi bộ nhớ đáng kể hơn. Khi một mô hình vượt quá bộ nhớ video (VRAM) khả dụng, nó sẽ tràn sang RAM hệ thống và sử dụng CPU cho các phép tính, làm chậm đáng kể tốc độ tạo token. Trong trường hợp này, khung tác nhân từ chối bất kỳ mô hình nào có cửa sổ ngữ cảnh nhỏ hơn 64K, loại bỏ nhiều mô hình nhỏ hơn, nhanh hơn vốn có thể vừa vặn hoàn toàn trên GPU.
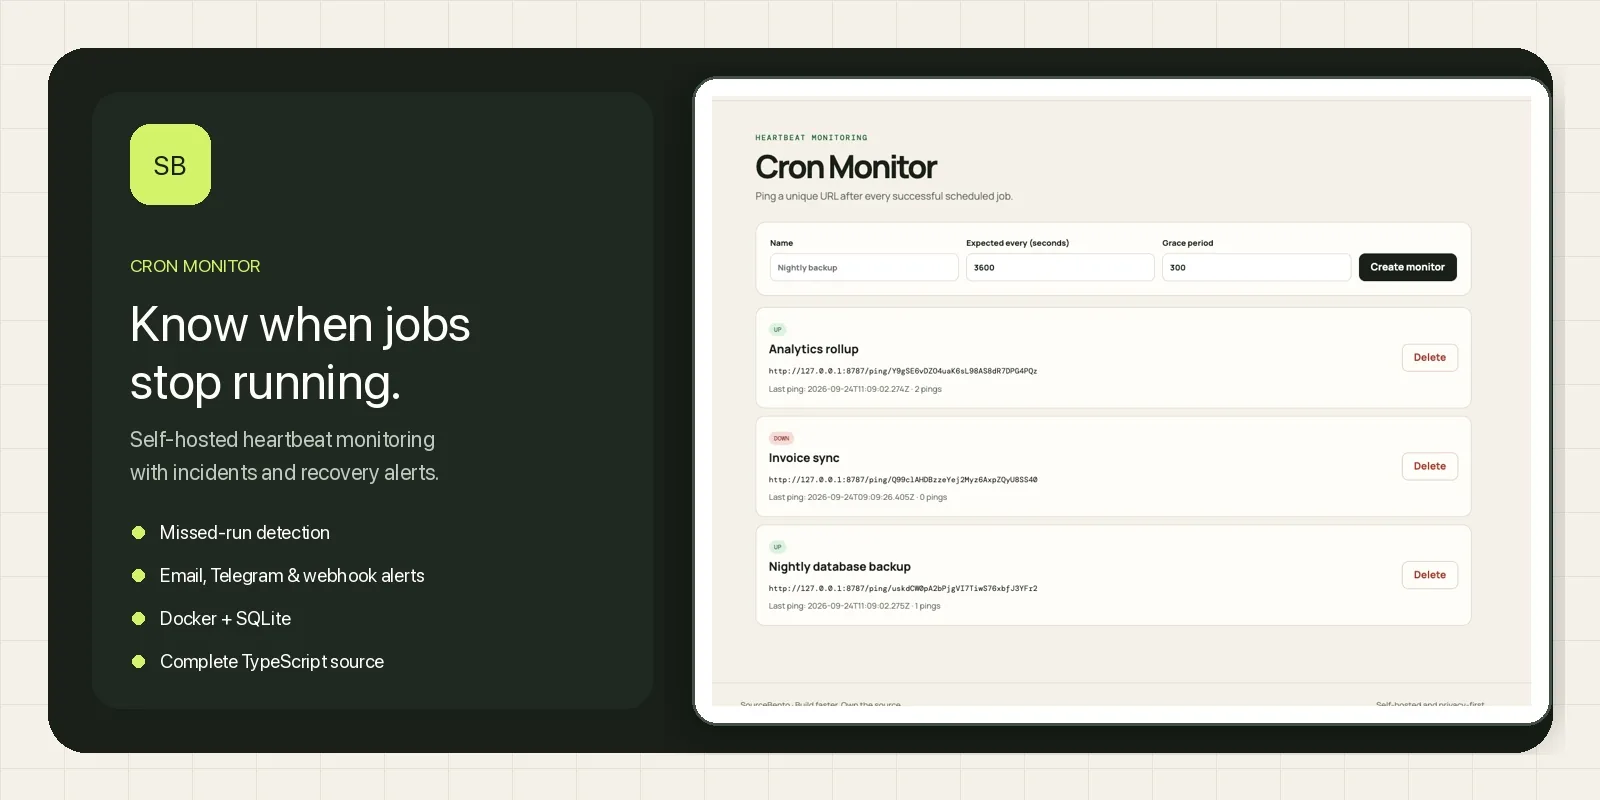
Giám sát các hệ thống phân tán thường dựa vào các kiểm tra nhịp tim (heartbeat checks), nơi một dịch vụ báo cáo trạng thái của nó ở các khoảng thời gian đều đặn. Nếu một kiểm tra thất bại, các hệ thống tự động thường kích hoạt cảnh báo hoặc quy trình failover. Tuy nhiên, các cơ chế này có thể bị đánh lừa bởi các lỗi không chuẩn, chẳng hạn như một đầu dò bị từ chối bởi bộ lọc nội dung thay vì máy chủ bị sập. Việc hiểu rõ sự khác biệt giữa một lỗi cứng và một sự từ chối logic là rất quan trọng để duy trì thời gian hoạt động tin cậy trong các homelab phức tạp.
Tại sao điều này quan trọng
Đối với các đội ngũ vận hành phần mềm của riêng mình, cuộc tổng điều tra này minh họa cho sự phức tạp ẩn giấu trong việc quản lý các quy trình làm việc AI lai. Nó chứng minh rằng thông số phần cứng đơn thuần không quyết định hiệu suất; các ràng buộc phần mềm như yêu cầu cửa sổ ngữ cảnh có thể buộc phải sử dụng đám mây đắt tiền ngay cả khi phần cứng cục bộ dường như đủ mạnh. Các kỹ sư phải đo lường mức sử dụng token thực tế và độ trễ thay vì dựa vào các thông số quảng cáo, vì các khối lượng công việc nặng về đầu vào có thể khiến các mô hình đám mây rẻ trở nên kinh tế hơn so với việc duy trì các máy chủ cục bộ lớn.
Sự cố mất điện kéo dài 17 ngày nêu bật tính mong manh của các hệ thống khôi phục tự động. Khi logic giám sát không tính đến tất cả các chế độ lỗi, chẳng hạn như bộ lọc phía trên chặn các đầu dò, các đội ngũ có thể không nhận ra hiệu suất bị suy giảm trong thời gian dài. Điều này củng cố nhu cầu về các công cụ quan sát (observability) mạnh mẽ có thể phân biệt giữa sự không sẵn sàng của dịch vụ và các lỗi logic, đảm bảo rằng các cơ chế dự phòng kích hoạt đúng cách và khôi phục hoạt động bình thường mà không cần can thiệp thủ công.
Bạn có thể làm gì
- Kiểm toán kho chứa container và máy ảo của bạn để xác định các dịch vụ trùng lặp hoặc tài nguyên không sử dụng đang tiêu tốn bộ nhớ.
- Đo lường tỷ lệ đầu vào và đầu ra token thực tế để xác định xem chi phí API đám mây được thúc đẩy bởi khối lượng hay lựa chọn mô hình.
- Triển khai giám sát nhịp tim cho tất cả các công việc nền quan trọng và dịch vụ AI để phát hiện các trường hợp treo hoặc đình trệ im lặng.
- Cấu hình các chuỗi dự phòng với nhiều nhà cung cấp khác nhau để tránh các điểm lỗi đơn lẻ khi một nhà cung cấp gặp sự cố.
- Thường xuyên thử nghiệm các đầu dò kiểm tra sức khỏe để đảm bảo chúng không bị chặn bởi các bộ lọc quyền riêng tư hoặc chính sách nội dung.
- Tạo các script để tự động giải phóng các mô hình nhàn rỗi khỏi bộ nhớ GPU nếu engine suy luận của bạn không xử lý tốt sự cạnh tranh tài nguyên.