Trennung von Heartbeat-Monitoring und Job-Logik für sicherere Rollbacks
Ein technischer Leitfaden erklärt, warum geplante Jobs externe Heartbeat-Monitore benötigen, um stille Fehler zu erkennen und sichere Rollbacks während des Deployments zu gewährleisten.
Automatisch aus dem englischen Original übersetzt.
Ein kürzlich am 3. Oktober 2026 veröffentlichter technischer Leitfaden skizziert eine Strategie zur Überwachung geplanter Node.js-Jobs mithilfe externer Heartbeat-Dienste. Der Autor argumentiert, dass die ausschließliche Abhängigkeit von internen Logs oder Metriken Blindstellen erzeugt, wenn ein Scheduler einen Task gar nicht erst startet. Durch die Entkopplung des Liveness-Signals von der Geschäftslogik können Teams stille Fehler erkennen und sicherere Rollbacks durchführen.
Was passiert ist
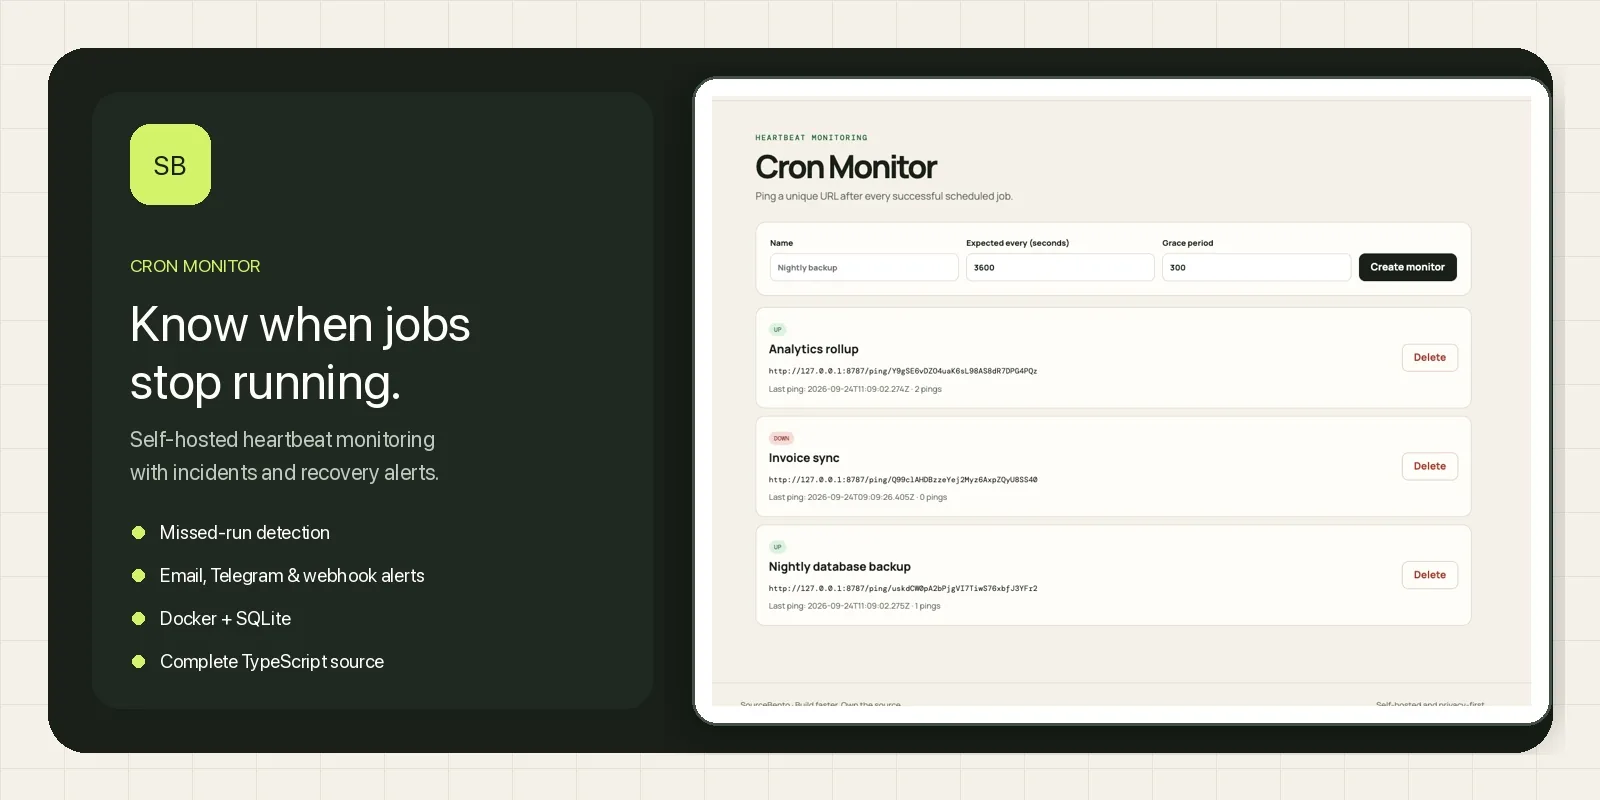
Der Artikel beschreibt ein spezifisches Architekturmodell für eine nächtliche Medien-Pipeline. Das Kernproblem besteht darin, dass traditionelle Protokollierung nicht beweisen kann, dass ein Job nie gestartet wurde. Wenn ein Container nicht initialisiert wird oder ein Cron-Zeitplan versehentlich entfernt wird, wird kein Fehlerprotokoll generiert. Um dies zu lösen, schlägt der Autor vor, einen dedizierten Heartbeat-Monitor zu verwenden, der nur dann einen Ping erwartet, wenn der Job seine Daten erfolgreich committet hat.
Die Implementierung erfordert, dass der Job eine Anfrage an eine eindeutige URL sendet, die von einem externen Monitoring-Dienst bereitgestellt wird. Diese Anfrage muss am Ende des Ausführungsflusses erfolgen, um sicherzustellen, dass Teilerfolge nicht als vollständiger Abschluss registriert werden. Der Autor betont, dass die Heartbeat-Frist außerhalb des geplanten Prozesses selbst liegen muss. Wenn dasselbe System entscheidet, ob es verspätet ist, und diese Antwort meldet, führt ein verpasster Aufruf zu totaler Stille.
Wichtig ist, dass der Leitfaden davor warnt, Verfügbarkeitsprüfungen des Anbieters in den kritischen Pfad des Jobs einzubetten. Die Validierung externer Abhängigkeiten bei jeder nächtlichen Ausführung koppelt den Erfolg der Pipeline an die Verfügbarkeit Dritter. Stattdessen empfiehlt der Autor, Bereitschaftsprüfungen während des Deployments durchzuführen. Dies hält den nächtlichen Job auf seine primäre Aufgabe fokussiert und stellt gleichzeitig sicher, dass die Umgebung gültig ist, bevor der Zeitplan beginnt.
Wichtige Details
- Heartbeat-Pings sollten nur nach dem dauerhaften Commit der Daten gesendet werden, um False Positives durch Teilfehler zu vermeiden.
- Karenzzeiten für Alarme müssen basierend auf der beobachteten Laufzeitverteilung und der Scheduler-Verzögerung festgelegt werden, nicht nur anhand der Cron-Zeitplanzeit.
- Job-Schreibvorgänge sollten idempotent sein, gekennzeichnet durch logische Perioden wie Veröffentlichungsdaten, um Wiederholungen ohne Duplizierung von Medienimporten zu handhaben.
- Strukturierte Logs sollten stabile Felder wie Jobname, Lauf-ID, Ergebnis und Anzahl der verarbeiteten Elemente enthalten, um effektive Suchanfragen zu ermöglichen.
- Die Reihenfolge beim Deployment ist entscheidend: Erstellen Sie zuerst die Heartbeat-Prüfung, deployen Sie dann die Job-Version und aktivieren Sie Benachrichtigungen zuletzt.
- Externe Observability-Anbieter sollten über eine vom Team verwaltete Schnittstelle angesprochen werden, um einen einfachen Wechsel ohne Änderung des Job-Codes zu ermöglichen.
Hintergrund
Heartbeat-Monitoring unterscheidet sich vom standardmäßigen Error-Tracking. Während Error-Tracker Ausnahmen erfassen, die während der Ausführung auftreten, erkennen Heartbeat-Monitore das Fehlen einer Aktivität. Sie arbeiten nach einem einfachen Prinzip: Wenn eine bestimmte URL innerhalb eines definierten Fensters nicht aufgerufen wird, wird ein Vorfall ausgelöst. Diese Unterscheidung ist für geplante Aufgaben entscheidend, bei denen der Fehlermodus oft Nicht-Ausführung statt abgestürzter Ausführung ist.
Idempotenz bedeutet in diesem Kontext, dass mehrmaliges Ausführen desselben Jobs mit denselben Eingaben keine duplizierten Seiteneffekte erzeugt. Für eine Medien-Pipeline könnte dies bedeuten, vor dem Import zu prüfen, ob eine Datei für ein bestimmtes Datum bereits existiert. Dieses Sicherheitsnetz ermöglicht es dem Scheduler, fehlgeschlagene Heartbeats oder Netzwerkprobleme neu zu versuchen, ohne den Datensatz zu beschädigen.
Warum es wichtig ist
Für Teams, die Self-Hosted-Software betreiben, sind stille Fehler besonders gefährlich. Ein Backup-Job, der aufgrund eines Konfigurationsfehlers nicht startet, bleibt möglicherweise wochenlang unbemerkt, bis ein Datenverlust offensichtlich wird. Interne Logs sind in diesem Szenario nutzlos, da kein Prozess vorhanden ist, der sie generieren könnte. Ein externer Heartbeat bietet einen unabhängigen Zeugen, der bestätigt, dass der Job tatsächlich ausgeführt wurde.
Dieser Ansatz vereinfacht auch Rollback-Prozeduren. Wenn eine neue Version eines Jobs deployed wird, kann sie weiterhin denselben Heartbeat-Vertrag wie die vorherige Version nutzen. Enthält der neue Code einen Bug, bricht der Rollback auf die alte Version nicht das Monitoring-Setup. Der Monitoring-Dienst bleibt gegenüber der internen Implementierung agnostisch und achtet nur darauf, dass das Signal rechtzeitig eintrifft.
Darüber hinaus verhindert die Trennung des Monitoring-Vertrags vom Anbieter Lock-in-Effekte. Durch die Verwendung einer einfachen HTTP-Anfrage an eine eindeutige URL können Teams zwischen Monitoring-Anbietern wie Healthchecks.io, Cronitor oder Self-Hosted-Lösungen wechseln, ohne ihre Job-Logik umzuschreiben. Diese Flexibilität ist für langfristige Wartung und Kostenmanagement unerlässlich.
Was Sie tun können
- Auditieren Sie bestehende Cron-Jobs, um solche zu identifizieren, denen externe Liveness-Checks fehlen, insbesondere kritische Backups und Datensynchronisierungen.
- Implementieren Sie idempotente Schreibvorgänge in geplanten Tasks, indem Sie Operationen auf logische Identifikatoren statt auf zufällige Run-IDs stützen.
- Konfigurieren Sie Heartbeat-Karenzzeiten so, dass sie die typische Job-Dauer plus einen Puffer für Scheduler-Latenzen berücksichtigen.
- Stellen Sie Monitoring-Endpunkte bereit, bevor Sie den Job-Code aktualisieren, um kontinuierliche Abdeckung während des Übergangs zu gewährleisten.
- Verwenden Sie strukturiertes Logging mit konsistenten Feldnamen, um effektive Post-Mortem-Analysen bei Vorfällen zu ermöglichen.
- Testen Sie Rollback-Szenarien, indem Sie einen fehlgeschlagenen Heartbeat simulieren und überprüfen, ob die vorherige Job-Version korrekt berichtet.