Tách biệt giám sát heartbeat khỏi logic công việc để đảm bảo rollback an toàn
Một hướng dẫn kỹ thuật giải thích lý do các tác vụ định kỳ cần trình giám sát heartbeat bên ngoài để phát hiện lỗi im lặng và đảm bảo quy trình rollback an toàn trong quá trình triển khai.
Bài được dịch tự động từ bản gốc tiếng Anh.
Một hướng dẫn kỹ thuật gần đây, được công bố vào ngày 3 tháng 10 năm 2026, phác thảo chiến lược giám sát các tác vụ định kỳ Node.js bằng cách sử dụng dịch vụ heartbeat bên ngoài. Tác giả lập luận rằng việc chỉ dựa vào nhật ký nội bộ hoặc số liệu đo lường sẽ tạo ra những điểm mù khi trình lập lịch thất bại hoàn toàn trong việc khởi chạy một tác vụ. Bằng cách tách tín hiệu trạng thái hoạt động (liveness signal) khỏi logic nghiệp vụ, các nhóm có thể phát hiện các lỗi im lặng và thực hiện quy trình rollback an toàn hơn.
Chuyện gì đã xảy ra
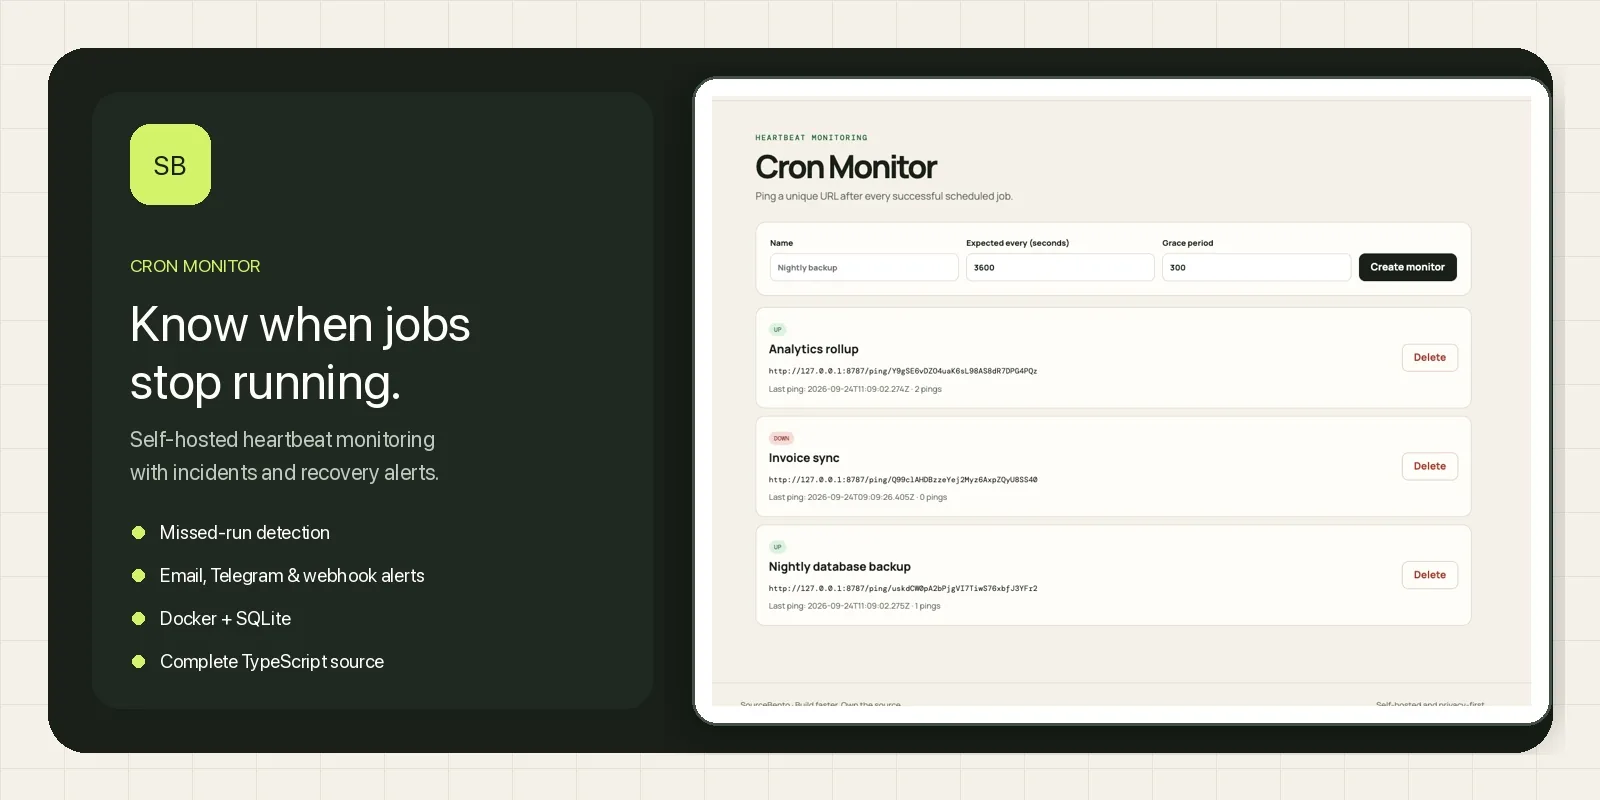
Bài viết chi tiết hóa một mẫu kiến trúc cụ thể cho đường ống xử lý phương tiện truyền thông hàng đêm. Vấn đề cốt lõi được giải quyết là nhật ký truyền thống không thể chứng minh rằng một tác vụ chưa bao giờ bắt đầu. Nếu container không khởi tạo thành công hoặc lịch cron bị xóa vô tình, sẽ không có nhật ký lỗi nào được tạo ra. Để giải quyết điều này, tác giả đề xuất sử dụng một trình giám sát heartbeat chuyên dụng, chỉ mong đợi nhận được tín hiệu ping sau khi tác vụ cam kết dữ liệu thành công.
Việc triển khai yêu cầu tác vụ gửi một yêu cầu đến một URL duy nhất do dịch vụ giám sát bên ngoài cung cấp. Yêu cầu này phải diễn ra ở cuối cùng của luồng thực thi, đảm bảo rằng các thành công một phần không được ghi nhận là hoàn tất. Tác giả nhấn mạnh rằng thời hạn heartbeat phải tồn tại độc lập với chính quy trình được lập lịch. Nếu cùng một hệ thống vừa quyết định xem nó có bị trễ hay không, vừa báo cáo câu trả lời, thì việc bỏ lỡ lệnh gọi sẽ dẫn đến sự im lặng tuyệt đối.
Quan trọng hơn, hướng dẫn cảnh báo chống lại việc đặt các kiểm tra tính sẵn sàng của nhà cung cấp vào trong đường dẫn quan trọng (critical path) của tác vụ. Việc xác thực các phụ thuộc bên ngoài trong mỗi lần thực thi hàng đêm sẽ gắn liền thành công của đường ống với thời gian hoạt động của bên thứ ba. Thay vào đó, tác giả gợi ý chạy các kiểm tra sẵn sàng trong quá trình triển khai. Điều này giữ cho tác vụ hàng đêm tập trung vào nhiệm vụ chính của nó, đồng thời đảm bảo môi trường hợp lệ trước khi lịch trình bắt đầu.
Chi tiết chính
- Tín hiệu heartbeat chỉ nên được gửi sau khi dữ liệu bền vững (durable data) được cam kết, nhằm ngăn chặn các dương tính giả từ những lỗi một phần.
- Thời gian ân hạn (grace periods) cho cảnh báo phải được thiết lập dựa trên phân phối thời gian chạy quan sát được và độ trễ của trình lập lịch, chứ không chỉ dựa vào thời gian lịch cron.
- Các thao tác ghi của tác vụ nên mang tính idempotent (đồng nhất), được khóa theo các khoảng thời gian logic như ngày xuất bản, để xử lý các lần thử lại mà không làm trùng lặp việc nhập phương tiện truyền thông.
- Nhật ký có cấu trúc nên bao gồm các trường ổn định như tên tác vụ, định danh lần chạy, kết quả và số lượng mục đã xử lý để tìm kiếm hiệu quả.
- Thứ tự triển khai rất quan trọng: tạo kiểm tra heartbeat trước, sau đó triển khai phiên bản tác vụ, và cuối cùng mới bật thông báo.
- Các nhà cung cấp khả năng quan sát bên ngoài nên được truy cập qua một giao diện thuộc sở hữu của ứng dụng, cho phép dễ dàng thay đổi mà không cần sửa đổi mã nguồn của tác vụ.
Bối cảnh
Giám sát heartbeat khác với theo dõi lỗi tiêu chuẩn. Trong khi các trình theo dõi lỗi nắm bắt các ngoại lệ xảy ra trong quá trình thực thi, các trình giám sát heartbeat phát hiện sự vắng mặt. Chúng hoạt động theo một nguyên tắc đơn giản: nếu một URL cụ thể không được truy cập trong một khung thời gian xác định, một sự cố sẽ được kích hoạt. Sự khác biệt này rất quan trọng đối với các tác vụ định kỳ, nơi chế độ lỗi thường là không thực thi chứ không phải thực thi bị sụp đổ.
Tính idempotent trong bối cảnh này có nghĩa là chạy cùng một tác vụ nhiều lần với cùng một đầu vào sẽ không tạo ra các tác dụng phụ trùng lặp. Đối với đường ống xử lý phương tiện truyền thông, điều này có thể có nghĩa là kiểm tra xem tệp cho một ngày cụ thể đã tồn tại hay chưa trước khi nhập nó. Lưới an toàn này cho phép trình lập lịch thử lại các heartbeat thất bại hoặc lỗi mạng mà không làm hỏng tập dữ liệu.
Tại sao điều này quan trọng
Đối với các nhóm vận hành phần mềm tự lưu trữ (self-hosted software), các lỗi im lặng đặc biệt nguy hiểm. Một tác vụ sao lưu không thể bắt đầu do lỗi cấu hình có thể không được chú ý trong nhiều tuần cho đến khi mất dữ liệu trở nên rõ ràng. Nhật ký nội bộ vô ích trong kịch bản này vì không có quy trình nào để tạo ra chúng. Một heartbeat bên ngoài cung cấp một nhân chứng độc lập xác nhận rằng tác vụ thực sự đã chạy.
Cách tiếp cận này cũng đơn giản hóa các quy trình rollback. Khi một phiên bản mới của tác vụ được triển khai, nó có thể tiếp tục sử dụng cùng một hợp đồng heartbeat như phiên bản trước. Nếu mã mới chứa lỗi, việc rollback về phiên bản cũ không làm hỏng thiết lập giám sát. Dịch vụ giám sát vẫn không quan tâm đến triển khai nội bộ, chỉ quan tâm đến việc tín hiệu có đến đúng lúc hay không.
Hơn nữa, việc tách hợp đồng giám sát khỏi nhà cung cấp giúp ngăn chặn tình trạng khóa chặt (lock-in). Bằng cách sử dụng một yêu cầu HTTP đơn giản đến một URL duy nhất, các nhóm có thể chuyển đổi giữa các nhà cung cấp giám sát như Healthchecks.io, Cronitor hoặc các giải pháp tự lưu trữ mà không cần viết lại logic tác vụ. Tính linh hoạt này là thiết yếu cho việc bảo trì dài hạn và quản lý chi phí.
Bạn có thể làm gì
- Kiểm toán các tác vụ cron hiện có để xác định những tác vụ thiếu kiểm tra liveness bên ngoài, đặc biệt là các bản sao lưu quan trọng và đồng bộ dữ liệu.
- Triển khai các thao tác ghi idempotent trong các tác vụ định kỳ bằng cách khóa các hoạt động dựa trên định danh logic thay vì ID lần chạy ngẫu nhiên.
- Cấu hình thời gian ân hạn heartbeat để tính đến thời lượng tác vụ điển hình cộng với một bộ đệm cho độ trễ của trình lập lịch.
- Triển khai các endpoint giám sát trước khi cập nhật mã tác vụ để đảm bảo phạm vi phủ sóng liên tục trong quá trình chuyển đổi.
- Sử dụng nhật ký có cấu trúc với tên trường nhất quán để cho phép phân tích hậu sự cố (post-mortem analysis) hiệu quả khi các sự cố xảy ra.
- Kiểm thử các kịch bản rollback bằng cách mô phỏng một heartbeat thất bại và xác minh rằng phiên bản tác vụ trước đó vẫn báo cáo chính xác.