Separar el monitoreo de latido de la lógica del trabajo para rollbacks más seguros
Una guía técnica explica por qué los trabajos programados necesitan monitores de latido externos para detectar fallos silenciosos y garantizar rollbacks seguros durante el despliegue.
Traducido automáticamente del original en inglés.
Una reciente guía técnica publicada el 3 de octubre de 2026 describe una estrategia para monitorizar trabajos programados en Node.js mediante servicios de latido (heartbeat) externos. El autor argumenta que depender únicamente de registros internos o métricas crea puntos ciegos cuando un planificador no logra iniciar una tarea por completo. Al desacoplar la señal de vitalidad de la lógica de negocio, los equipos pueden detectar fallos silenciosos y realizar rollbacks más seguros.
Qué ocurrió
El artículo detalla un patrón arquitectónico específico para un pipeline de medios nocturno. El problema central abordado es que los registros tradicionales no pueden demostrar que un trabajo nunca se inició. Si un contenedor falla al inicializarse o se elimina accidentalmente una programación cron, no se genera ningún registro de error. Para resolver esto, el autor propone utilizar un monitor de latido dedicado que espera un ping solo después de que el trabajo confirme exitosamente sus datos.
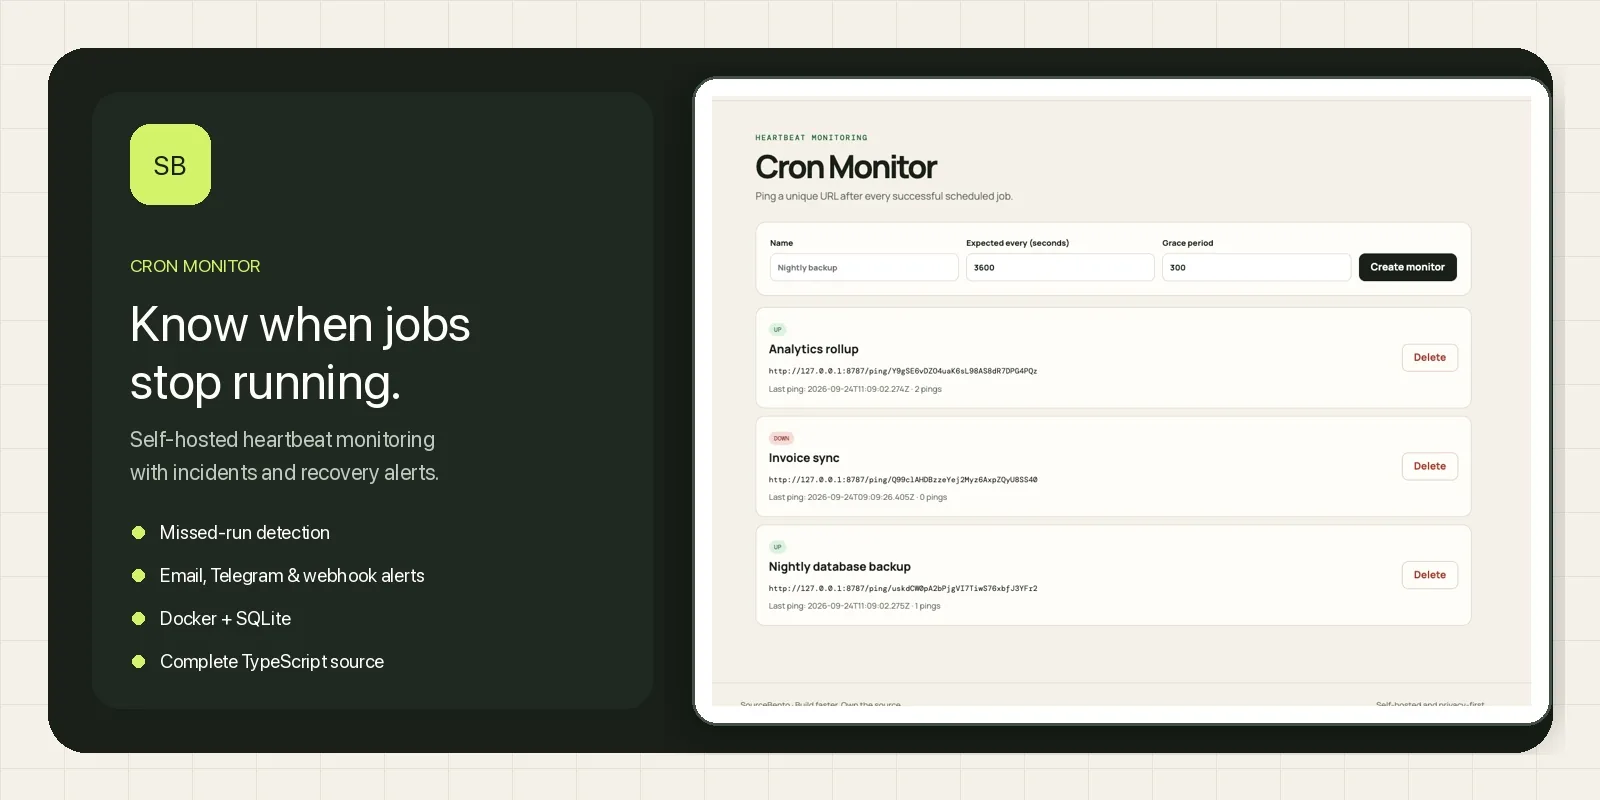
La implementación requiere que el trabajo envíe una solicitud a una URL única proporcionada por un servicio de monitoreo externo. Esta solicitud debe ocurrir al final absoluto del flujo de ejecución, asegurando que los éxitos parciales no se registren como completos. El autor enfatiza que el plazo límite del latido debe existir fuera del proceso programado en sí. Si el mismo sistema decide si está retrasado e informa la respuesta, una invocación perdida resulta en silencio total.
Crucialmente, la guía advierte contra la colocación de comprobaciones de disponibilidad del proveedor dentro de la ruta crítica del trabajo. Validar dependencias externas durante cada ejecución nocturna acopla el éxito del pipeline a la disponibilidad de terceros. En su lugar, el autor sugiere ejecutar comprobaciones de preparación durante el despliegue. Esto mantiene el trabajo nocturno enfocado en su tarea principal mientras asegura que el entorno sea válido antes de que comience la programación.
Detalles clave
- Los pings de latido solo deben enviarse después de confirmar datos duraderos para evitar falsos positivos derivados de fallos parciales.
- Los períodos de gracia para las alertas deben establecerse basándose en la distribución observada del tiempo de ejecución y el retraso del planificador, no solo en la hora del programa cron.
- Las escrituras del trabajo deben ser idempotentes, indexadas por períodos lógicos como fechas de publicación, para manejar reintentos sin duplicar importaciones de medios.
- Los registros estructurados deben incluir campos estables como nombre del trabajo, identificador de ejecución, resultado y cantidad de elementos procesados para búsquedas efectivas.
- La secuencia de despliegue importa: crear primero la comprobación de latido, luego desplegar la versión del trabajo y habilitar las notificaciones al final.
- Los proveedores de observabilidad externa deben accederse a través de una interfaz propiedad de la aplicación para permitir cambios fáciles sin modificar el código del trabajo.
Contexto
El monitoreo de latido difiere del seguimiento estándar de errores. Mientras que los rastreadores de errores capturan excepciones que ocurren durante la ejecución, los monitores de latido detectan ausencias. Operan bajo un principio simple: si una URL específica no se visita dentro de una ventana definida, se levanta un incidente. Esta distinción es vital para tareas programadas donde el modo de fallo suele ser la no-ejecución en lugar de una ejecución fallida.
La idempotencia en este contexto significa que ejecutar el mismo trabajo múltiples veces con la misma entrada no produce efectos secundarios duplicados. Para un pipeline de medios, esto podría significar comprobar si un archivo para una fecha específica ya existe antes de importarlo. Esta red de seguridad permite al planificador reintentar latidos fallidos o problemas de red sin corromper el conjunto de datos.
Por qué importa
Para equipos que ejecutan software autoalojado, los fallos silenciosos son particularmente peligrosos. Un trabajo de copia de seguridad que falla al iniciarse debido a un error de configuración puede pasar desapercibido durante semanas hasta que la pérdida de datos se hace evidente. Los registros internos son inútiles en este escenario porque no hay proceso para generarlos. Un latido externo proporciona un testigo independiente que confirma que el trabajo realmente se ejecutó.
Este enfoque también simplifica los procedimientos de rollback. Cuando se despliega una nueva versión de un trabajo, puede continuar utilizando el mismo contrato de latido que la versión anterior. Si el nuevo código contiene un bug, revertir a la versión antigua no rompe la configuración de monitoreo. El servicio de monitoreo permanece agnóstico respecto a la implementación interna, interesándose solo en que la señal llegue a tiempo.
Además, separar el contrato de monitoreo del proveedor evita el lock-in (dependencia). Utilizando una simple solicitud HTTP a una URL única, los equipos pueden cambiar entre proveedores de monitoreo como Healthchecks.io, Cronitor o soluciones autoalojadas sin reescribir su lógica de trabajo. Esta flexibilidad es esencial para el mantenimiento a largo plazo y la gestión de costos.
Qué puedes hacer
- Auditar los trabajos cron existentes para identificar aquellos que carecen de comprobaciones externas de vitalidad, especialmente copias de seguridad críticas y sincronizaciones de datos.
- Implementar escrituras idempotentes en tareas programadas indexando operaciones sobre identificadores lógicos en lugar de IDs de ejecución aleatorios.
- Configurar períodos de gracia para latidos que tengan en cuenta la duración típica del trabajo más un margen para la latencia del planificador.
- Desplegar endpoints de monitoreo antes de actualizar el código del trabajo para asegurar una cobertura continua durante la transición.
- Usar registros estructurados con nombres de campo consistentes para habilitar análisis post-mortem efectivos cuando ocurran incidentes.
- Probar escenarios de rollback simulando un latido fallido y verificando que la versión anterior del trabajo siga reportando correctamente.