Séparer la surveillance par signal de vie de la logique des tâches pour des retours arrière plus sûrs
Un guide technique explique pourquoi les tâches planifiées nécessitent des moniteurs externes de signal de vie pour détecter les défaillances silencieuses et garantir des retours arrière sûrs lors du déploiement.
Traduit automatiquement depuis l’original en anglais.
Un récent guide technique publié le 3 octobre 2026 décrit une stratégie de surveillance des tâches planifiées Node.js à l'aide de services externes de signal de vie. L'auteur soutient que se fier uniquement aux journaux internes ou aux métriques crée des angles morts lorsqu'un ordonnanceur ne lance pas entièrement une tâche. En découplant le signal de présence de la logique métier, les équipes peuvent détecter les défaillances silencieuses et effectuer des retours arrière plus sûrs.
Ce qui s'est passé
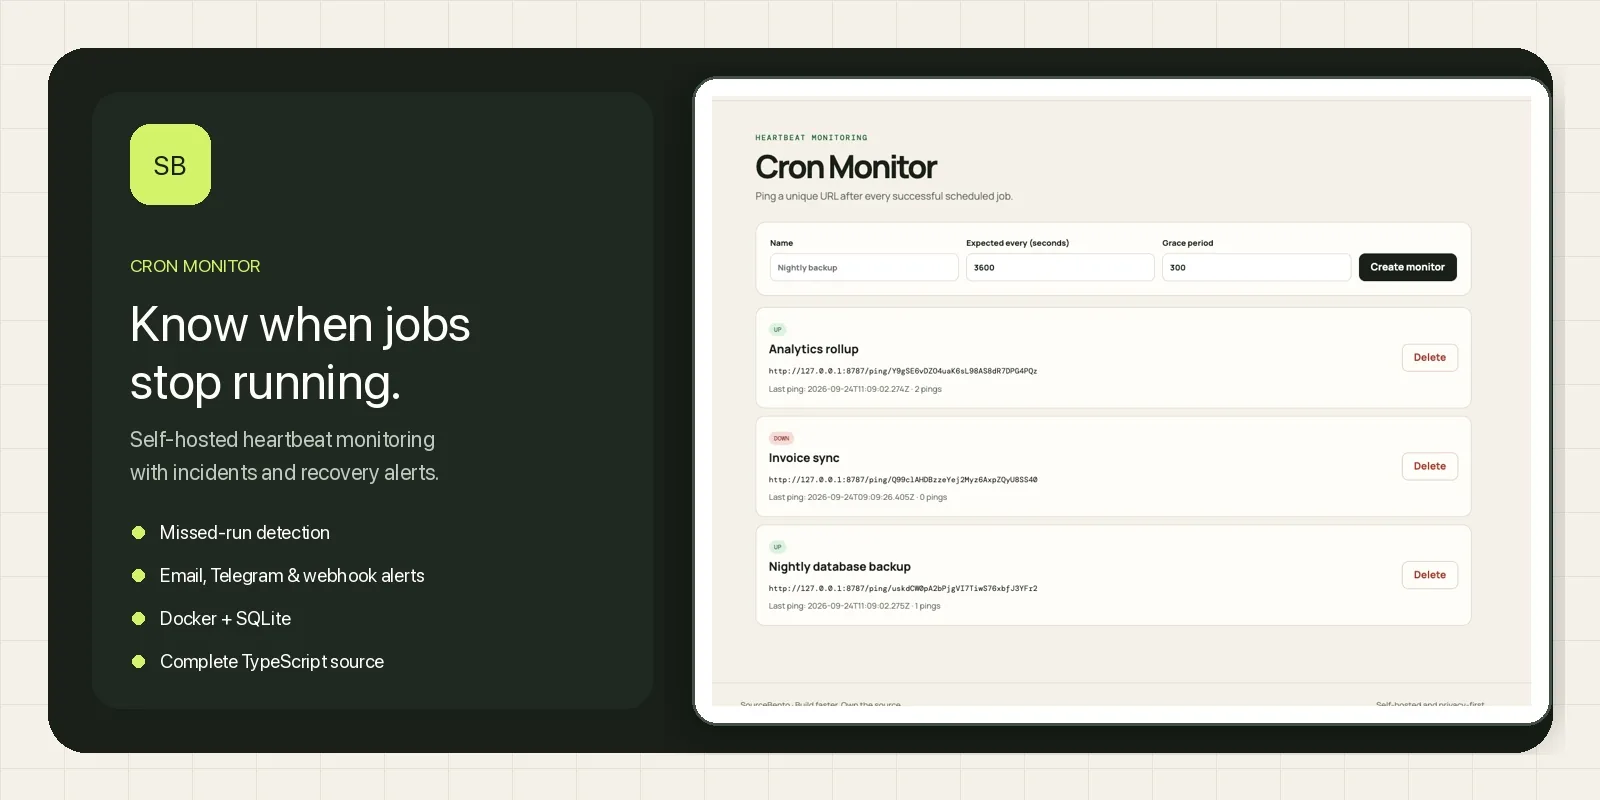
L'article détaille un modèle architectural spécifique pour un pipeline média nocturne. Le problème central abordé est que la journalisation traditionnelle ne peut pas prouver qu'une tâche n'a jamais démarré. Si un conteneur échoue à l'initialisation ou si une planification cron est accidentellement supprimée, aucun journal d'erreur n'est généré. Pour résoudre ce problème, l'auteur propose d'utiliser un moniteur de signal de vie dédié qui attend un ping uniquement après que la tâche a réussi à valider ses données.
La mise en œuvre exige que la tâche envoie une requête à une URL unique fournie par un service de surveillance externe. Cette requête doit se produire à la toute fin du flux d'exécution, garantissant ainsi que les succès partiels ne soient pas enregistrés comme complets. L'auteur souligne que le délai limite du signal de vie doit exister en dehors du processus planifié lui-même. Si le même système décide s'il est en retard et rapporte la réponse, une invocation manquée entraîne un silence total.
De manière cruciale, le guide met en garde contre la place des vérifications de disponibilité des fournisseurs dans le chemin critique de la tâche. Valider les dépendances externes lors de chaque exécution nocturne couple le succès du pipeline à la disponibilité des tiers. Au lieu de cela, l'auteur suggère d'effectuer des vérifications de préparation lors du déploiement. Cela permet à la tâche nocturne de rester concentrée sur sa tâche principale tout en s'assurant que l'environnement est valide avant le début de la planification.
Détails clés
- Les pings de signal de vie ne doivent être envoyés qu'après la validation durable des données pour éviter les faux positifs dus aux défaillances partielles.
- Les périodes de grâce pour les alertes doivent être définies en fonction de la distribution observée du temps d'exécution et du retard de l'ordonnanceur, et non seulement de l'heure de la planification cron.
- Les écritures de tâches doivent être idempotentes, indexées par des périodes logiques telles que les dates de publication, pour gérer les nouvelles tentatives sans dupliquer les imports de médias.
- Les journaux structurés doivent inclure des champs stables tels que le nom de la tâche, l'identifiant d'exécution, le résultat et le nombre d'éléments traités pour une recherche efficace.
- La séquence de déploiement est importante : créez d'abord la vérification du signal de vie, puis déployez la version de la tâche, et activez les notifications en dernier.
- Les fournisseurs d'observabilité externes doivent être accessibles via une interface appartenant à l'application pour permettre un remplacement facile sans modifier le code de la tâche.
Contexte
La surveillance par signal de vie diffère du suivi standard des erreurs. Alors que les traqueurs d'erreurs capturent les exceptions survenant pendant l'exécution, les moniteurs de signal de vie détectent l'absence. Ils fonctionnent selon un principe simple : si une URL spécifique n'est pas visitée dans une fenêtre définie, un incident est déclenché. Cette distinction est vitale pour les tâches planifiées où le mode de défaillance est souvent la non-exécution plutôt que l'exécution interrompue.
L'idempotence dans ce contexte signifie que l'exécution de la même tâche plusieurs fois avec la même entrée ne produit pas d'effets secondaires duplicatifs. Pour un pipeline média, cela pourrait signifier vérifier si un fichier pour une date spécifique existe déjà avant de l'importer. Ce filet de sécurité permet à l'ordonnanceur de réessayer les signaux de vie échoués ou les incidents réseau sans corrompre le jeu de données.
Pourquoi c'est important
Pour les équipes utilisant des logiciels auto-hébergés, les défaillances silencieuses sont particulièrement dangereuses. Une tâche de sauvegarde qui ne démarre pas en raison d'une erreur de configuration peut passer inaperçue pendant des semaines jusqu'à ce que la perte de données devienne apparente. Les journaux internes sont inutiles dans ce scénario car il n'y a pas de processus pour les générer. Un signal de vie externe fournit un témoin indépendant qui confirme que la tâche a réellement été exécutée.
Cette approche simplifie également les procédures de retour arrière. Lorsqu'une nouvelle version d'une tâche est déployée, elle peut continuer à utiliser le même contrat de signal de vie que la version précédente. Si le nouveau code contient un bug, le retour à l'ancienne version ne casse pas la configuration de surveillance. Le service de surveillance reste agnostique quant à la mise en œuvre interne, ne se souciant que de l'arrivée du signal dans les délais.
De plus, séparer le contrat de surveillance du fournisseur empêche le verrouillage technologique. En utilisant une simple requête HTTP vers une URL unique, les équipes peuvent changer entre des fournisseurs de surveillance comme Healthchecks.io, Cronitor ou des solutions auto-hébergées sans réécrire leur logique de tâche. Cette flexibilité est essentielle pour la maintenance à long terme et la gestion des coûts.
Ce que vous pouvez faire
- Auditez les tâches cron existantes pour identifier celles qui manquent de vérifications externes de présence, en particulier les sauvegardes critiques et les synchronisations de données.
- Implémentez des écritures idempotentes dans les tâches planifiées en indexant les opérations sur des identifiants logiques plutôt que sur des ID d'exécution aléatoires.
- Configurez les périodes de grâce du signal de vie pour tenir compte de la durée typique de la tâche plus une marge pour la latence de l'ordonnanceur.
- Déployez les points de terminaison de surveillance avant de mettre à jour le code de la tâche pour assurer une couverture continue pendant la transition.
- Utilisez la journalisation structurée avec des noms de champs cohérents pour permettre une analyse post-mortem efficace lorsque des incidents surviennent.
- Testez les scénarios de retour arrière en simulant un signal de vie échoué et en vérifiant que la version précédente de la tâche continue de signaler correctement.